
КЕЙС: Сквозная аналитика агентства — от визита на сайт до сделки в CRM
Клиент — агентство, которое продаёт сложную B2B-услугу с длинным циклом: от первого касания до подписанного контракта проходят недели, а чаще месяцы. Заявки приходят из десятка источников: отраслевые каталоги, органический поиск, соцсети, площадки с портфолио, статьи — и всё чаще AI-ассистенты. Команда видела трафик в Google Analytics и сделки в CRM — оставалось соединить эти два мира в одну картину, чтобы на главный вопрос бизнеса — какой канал приводит не посетителей, а клиентов — отвечали данные, а не догадки.
Собрали меньше чем за месяц с момента получения доступов: сквозную аналитику от первого визита на сайт до сделки в CRM, с собственным дашбордом, который обновляется каждый день и принадлежит клиенту вместе со всеми данными. Рассказываем, как это устроено.
Кейс публикуем в вайтлейбл-формате, по договорённости с клиентом: без названия компании и без её показателей. На снимках скрыта айдентика, числа размыты, названия стадий CRM обобщены — на устройство инструмента это не влияет, а именно оно здесь и интересно.
Технологии проекта
- Сбор данных: Google Analytics 4 — события, Data API для истории, Admin API; Google Tag Manager — теги, триггеры, куки первой стороны, API публикации; Google Search Console — массовая выгрузка (bulk export)
- Хранилище и обработка: Google BigQuery в облаке клиента, локация EU; Два слоя данных: core (нормализованные события и сессии) → marts (витрины); Standard SQL, сшивка истории с живым потоком по контрольной дате
- CRM: Pipedrive API — служебные поля сделки, стадии, история переходов
- Дашборд: Самодостаточный HTML / CSS / JavaScript — без конструкторов и лицензий; SVG-графики, пересчёт периодов и сравнение прямо в браузере; Айдентика клиента: её шрифт и цвета
- Сайт клиента: Современный JS-фреймворк — интеграция через dataLayer и куки первой стороны
- Инфраструктура: Python — загрузка данных, сборка дашборда и документов; Git — версии кода и документов; Ежедневная автоматизация: пересборка, контрольные суммы, свежесть данных, целостность стыка
1. Вводная часть
1.1. О клиенте и задаче
Длинный цикл продажи означает, что путь человека растянут во времени: он может прочитать статью, вернуться через месяц из каталога, ещё раз зайти напрямую — и только тогда оставить заявку. Поэтому вопрос «откуда пришёл этот клиент» здесь касается каждой сделки отдельно, а не статистики в целом.
Набор инструментов у клиента уже был: GA4 и Google Tag Manager на сайте, Search Console, CRM с собственной воронкой продаж. Каждый хорошо отвечал на свой вопрос — оставалось научить их отвечать на общий: соединить трафик со сделками, а сделки — с источниками.
Задачу сформулировали двумя вопросами:
- Какой канал приводит клиентов, а не просто сессии?
- На каком шаге формы люди останавливаются — и что с этим можно сделать?
Договорились об объёме: свести данные в одно место, сшить визиты со сделками и собрать дашборд, который отвечает на эти вопросы каждый день — без ручных выгрузок и без конструкторов отчётов.
1.2. Особенности проекта
Пять систем, которые надо свести в одну картину. GA4, GTM, Search Console, CRM и сам сайт. Данные надо было не «подключить», а привести к общему знаменателю: один человек — один идентификатор насквозь.
История глубже, чем показывает интерфейс GA4. Для сравнения года с годом и честной оценки сезонности нужны годы, а не месяцы. Поэтому историю забирали отдельно через API и сшивали с живым потоком.
Точность важнее объёма. Там, где конверсий тысячи, погрешность в несколько процентов незаметна. Здесь каждая сделка видна отдельной строкой, поэтому атрибуция должна быть точной: из неё следует ответ на вопрос «куда вкладывать».
Данные принадлежат клиенту. Договорились об этом сразу: всё живёт в облачном проекте самого клиента. Мы работаем в его проекте, а не забираем данные к себе. Всё собранное остаётся у клиента навсегда, независимо от того, кто работает с данными дальше.
Сайт многостраничный, форма двухшаговая, и форм несколько. Кнопка в хедере, модальное окно, встроенная форма на странице контактов. Формы рисуются на лету и имеют два шага, поэтому события надо отправлять из кода сайта, а не угадывать по кликам. Значит, разработчик клиента — полноправный участник проекта.
2. Работа над проектом
2.1. Фундамент: все данные в одном месте
Начали с инвентаризации: что собирается, куда, с какими настройками, у кого есть доступы. Наименее эффектная часть — и именно она определяет, выйдет ли остальное. Провели ревизию контейнера GTM и событий GA4, согласовали с клиентом, какой ресурс GA4 становится основным для выгрузки.
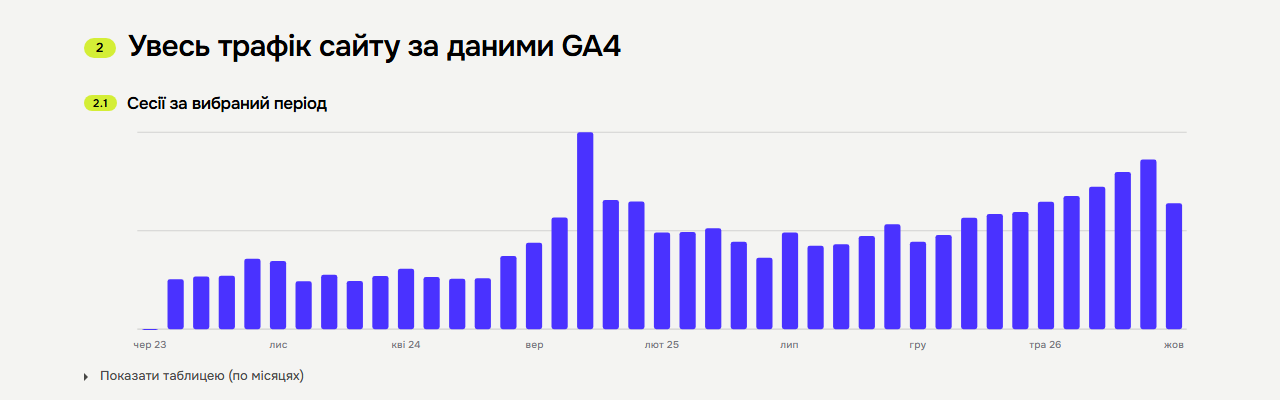
Дальше — хранилище. Развернули проект BigQuery в облаке клиента, включили ежедневную выгрузку GA4 и массовую выгрузку Search Console. Поверх сырых данных построили два слоя: core — нормализованные события и сессии, и marts — витрины, то есть готовые к показу срезы данных. У каждой цифры на дашборде есть свой запрос, и его можно проверить.
Отдельное правило, которого мы придерживались весь проект: одно название — один подсчёт. Если колонка называется «Заявки», она считается одинаково на каждой вкладке. Где два способа подсчёта дают разное — например, события об отправке формы против сессий, в которых была отправка, — мы показываем оба и объясняем разницу прямо в дашборде, а не прячем одно из них.
2.2. История, которая глубже выгрузки
Выгрузка в BigQuery начинается со дня, когда её включили. Всё, что было раньше, в экспорт не попадает. А клиенту нужна история со дня запуска сайта.
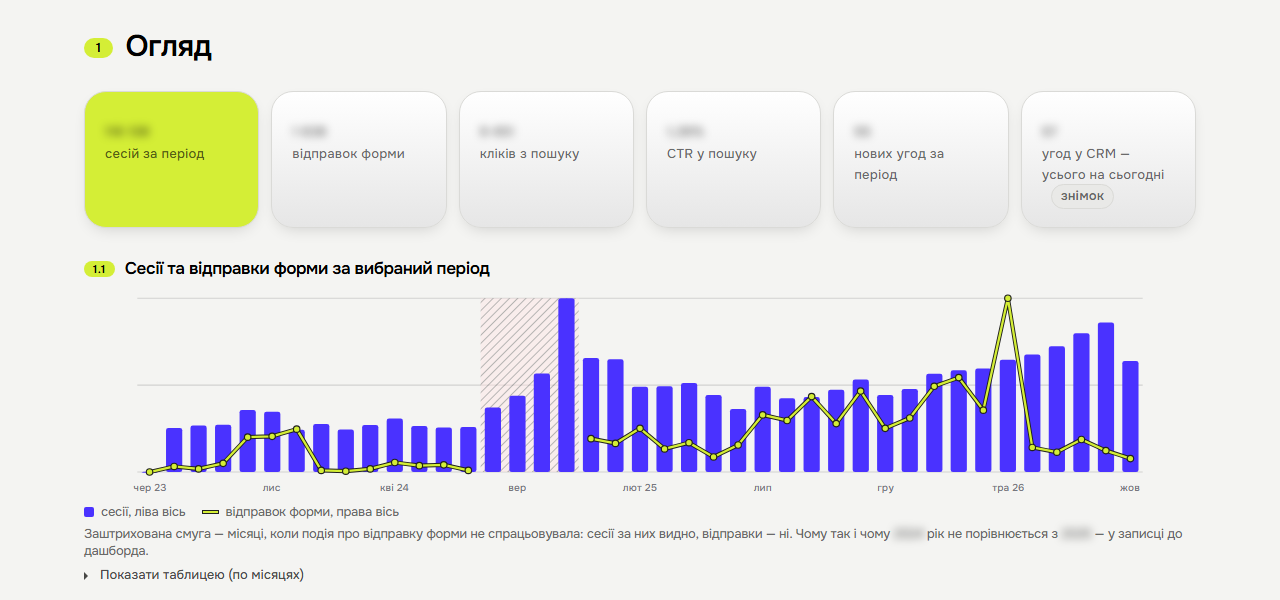
Мы забрали прошлое через GA4 Data API — по дням, каналам, источникам, страницам входа, странам и событиям — и сшили с экспортом по чёткой границе: до первого дня выгрузки работает история из API, с него — живые данные. Каждая витрина состоит из двух половин, и итоги сверяются. Так появились годы истории там, где интерфейс GA4 показал бы несколько месяцев.
2.3. Форма: события и воронка
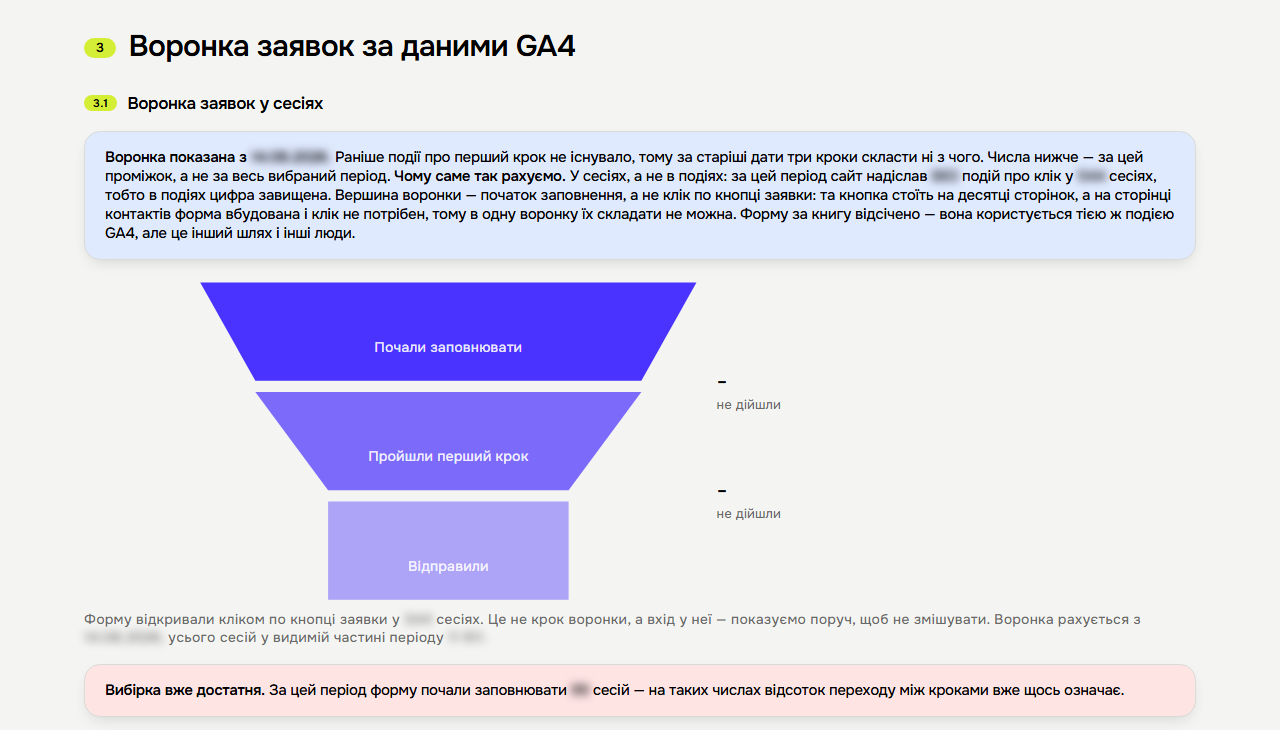
Чтобы видеть, на каком шаге люди останавливаются, форму надо мерить пошагово. Через GTM добавили события на начало заполнения, первый шаг и отправку — и отделили форму лид-магнита, которая пользуется той же механикой, но ведёт других людей другим путём.
Воронку считаем в сессиях, а не в событиях: один человек за одно заполнение может сгенерировать несколько событий, и счёт в событиях завышал бы каждый шаг. Вершина воронки — начало заполнения, а не клик по кнопке: кнопка стоит на десятках страниц, а на странице контактов форма встроена и клика не требует, поэтому складывать их в одну цепочку нельзя.
Отдельная работа — оставить в данных только настоящих посетителей: без тестовых сред, без наших собственных проверок, без служебных переходов команды. Так воронка показывает реальную картину, а не более приятную, чем она есть.
2.4. Стык с CRM: один человек — один идентификатор
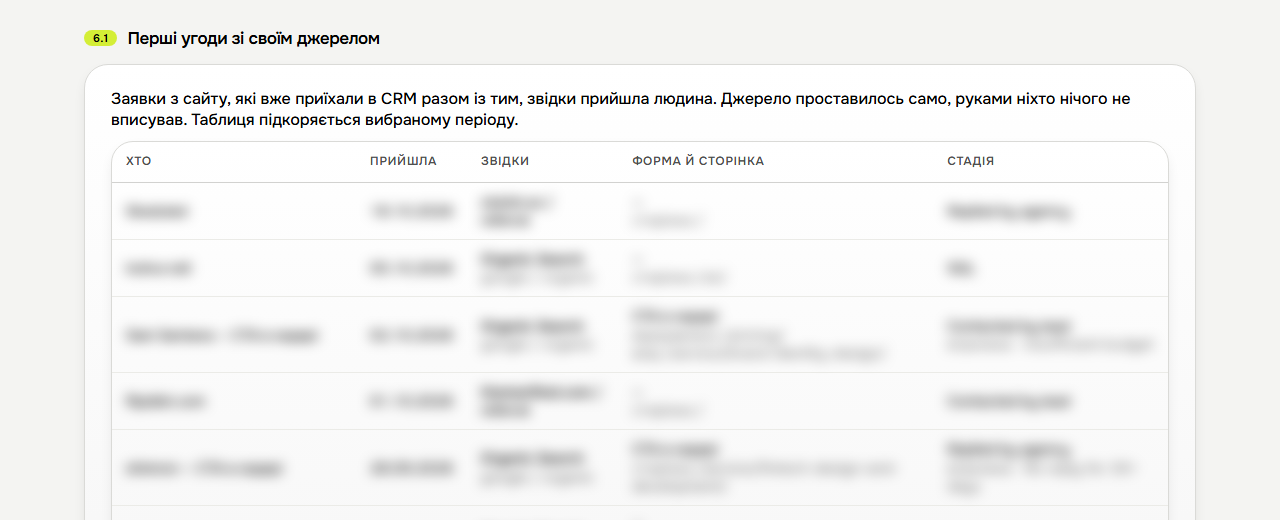
Это сердце проекта. Идея простая: идентификатор, который GA4 присваивает посетителю, должен доехать до карточки сделки в CRM. Тогда сделку можно соединить со всей историей визитов этого человека — и увидеть, откуда он пришёл впервые, что читал, сколько раз возвращался.
Как это устроено:
- Тег в GTM при первом визите записывает идентификатор GA4 и метки кампании в куки первой стороны — именно первого касания, а не последнего: нам важно, что человека привело, а не через что он вернулся.
- Форма на сайте читает эти куки и передаёт вместе с заявкой.
- Бэкенд клиента создаёт сделку в CRM и заполняет семь служебных полей: идентификатор визита, источник, тип трафика, кампанию, страницу заявки, идентификатор рекламного клика и формы. Поля мы спроектировали и создали через API, разработчику передали техническое задание с примерами.
- BigQuery соединяет сделку с визитами по идентификатору. С этого момента у каждой сделки есть канал, источник и первая страница входа.
Проверяли не на словах. Сначала отправили контрольные заявки через оба шага формы и сверили: идентификатор в карточке сделки совпадает с тем, что видит GA4, до символа; метки кампании доезжают полностью. Потом дождались настоящих заявок — и они приехали в CRM уже с источником: от органического поиска и соцсетей до отраслевых каталогов и AI-ассистентов. Ни одно поле не заполнялось руками.
2.5. Дашборд, который принадлежит клиенту
Мы сознательно не пошли в Looker Studio или другой конструктор. Дашборд — это один самодостаточный HTML-файл: открывается с любого устройства и не требует лицензий или аккаунтов. Все данные за всю историю уже внутри, а выбор периода и сравнение с предыдущим пересчитываются прямо в браузере.
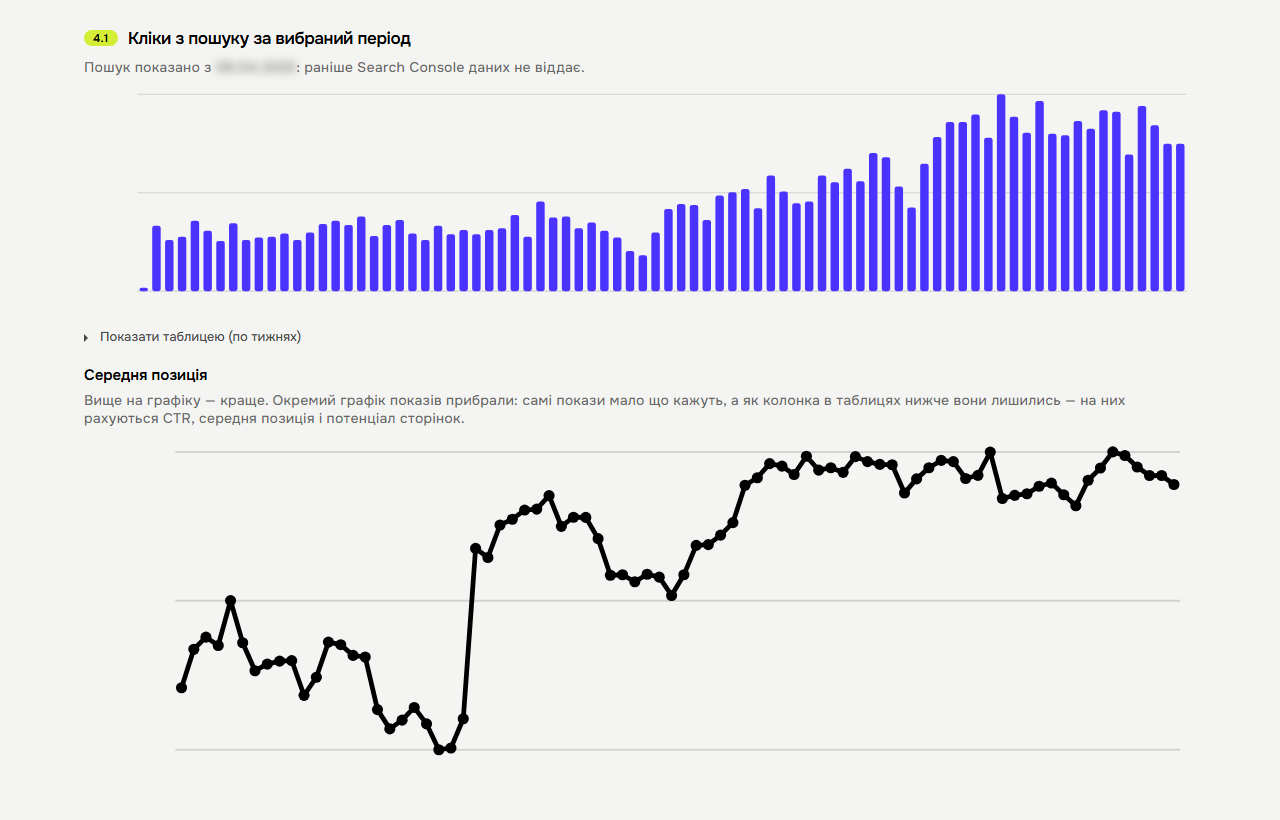
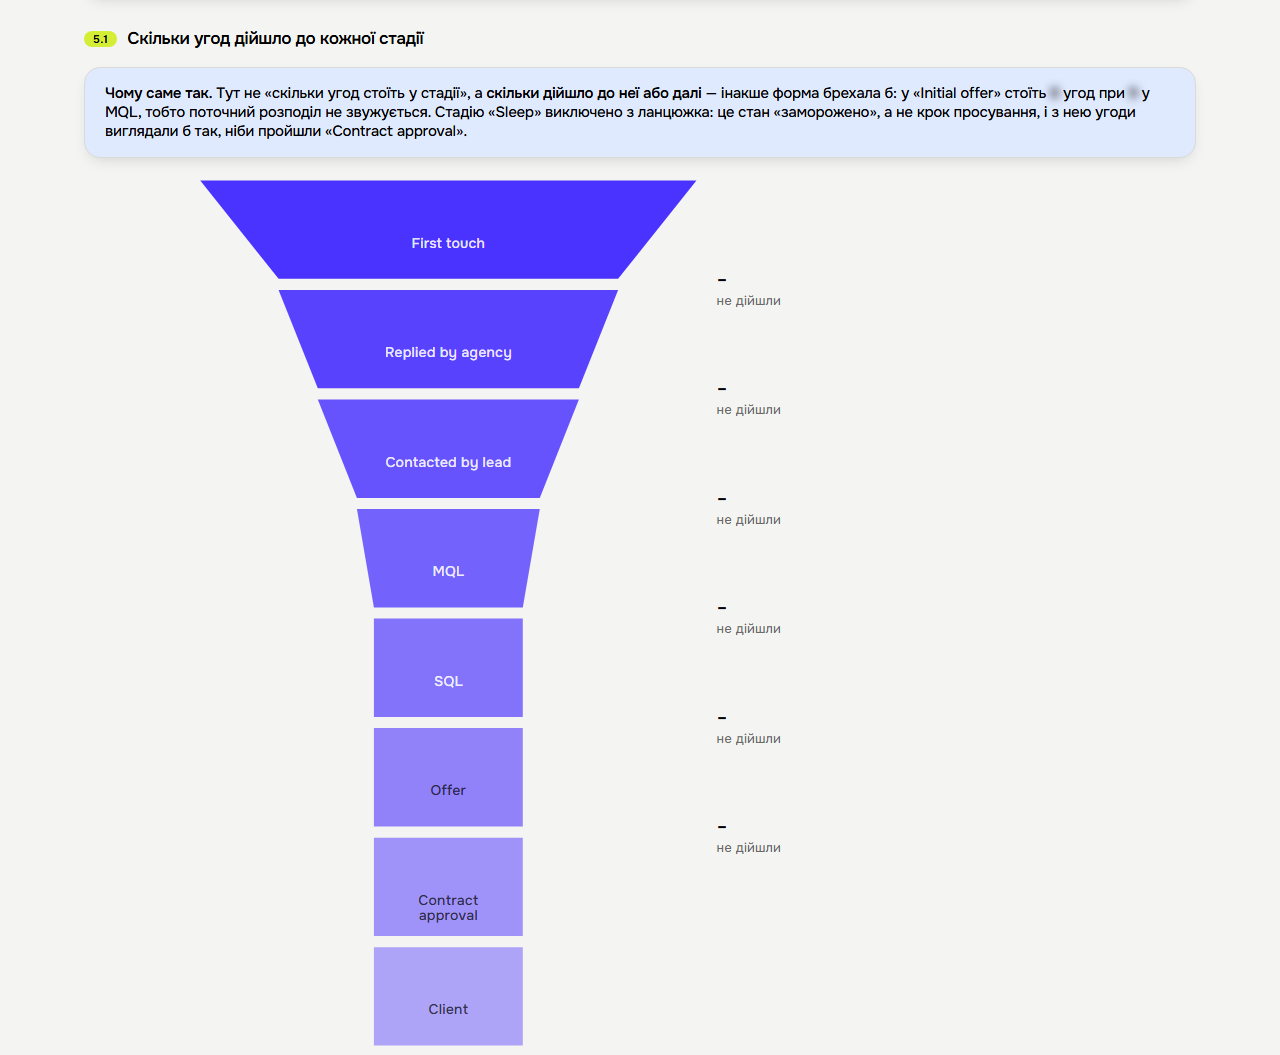
Девять разделов: обзор, трафик, воронка заявок, SEO, воронка продаж, каналы лидов — и три, которые уже ждут данных: менеджеры, услуги и выручка, реклама. В каждом написано, что здесь будет, какие данные для этого нужны и кто их даёт. Как только CRM наполнится суммами и статусами сделок, эти разделы начнут считать сами, без доработок.
Дашборд собран в айдентике клиента — его шрифт и его цвета. Разделы пронумерованы, чтобы в переписке можно было написать «смотрите 6.1» и человек нашёл место.
Обновление — каждый день, автоматически: подтягиваются данные CRM, пересобирается файл, проверяется, что данные сдвинулись, а стык не сломался.
2.6. Документы для команды
Аналитика работает только тогда, когда с ней работают люди. Поэтому вместе с дашбордом команда получила:
- Стандарт UTM-меток, построенный не на общих правилах, а на собственных данных клиента: какие написания источников уже рассыпались на несколько строк, какие типы трафика выпадают из каналов и почему. Главное правило там одно:
utm_medium— не описание вашего трафика, а значение из списка, который понимает GA4. - Рекомендации «что сделать с вашей стороны», отсортированные по ценности: сначала то, что открывает главный вопрос, потом то, что искажает имеющиеся цифры, потом вопросы на один ответ.
- Записку к дашборду с границами данных и методологией — чтобы цифрам доверяли не на слово.
Все документы собираются скриптами из живых данных: после изменений их достаточно пересобрать, и они сами покажут, что осталось.
3. Результаты
Главный результат: путь человека от первого визита до сделки виден насквозь. Это не отчёт, который кто-то собирает раз в квартал, а инструмент, который обновляется каждый день.
На какие вопросы он отвечает:
- Сколько сессий и отправок формы даёт каждый канал и каждый отдельный источник — не «Referral», а конкретный каталог или сайт.
- На каком шаге формы люди останавливаются: между началом и первым шагом или между первым шагом и отправкой.
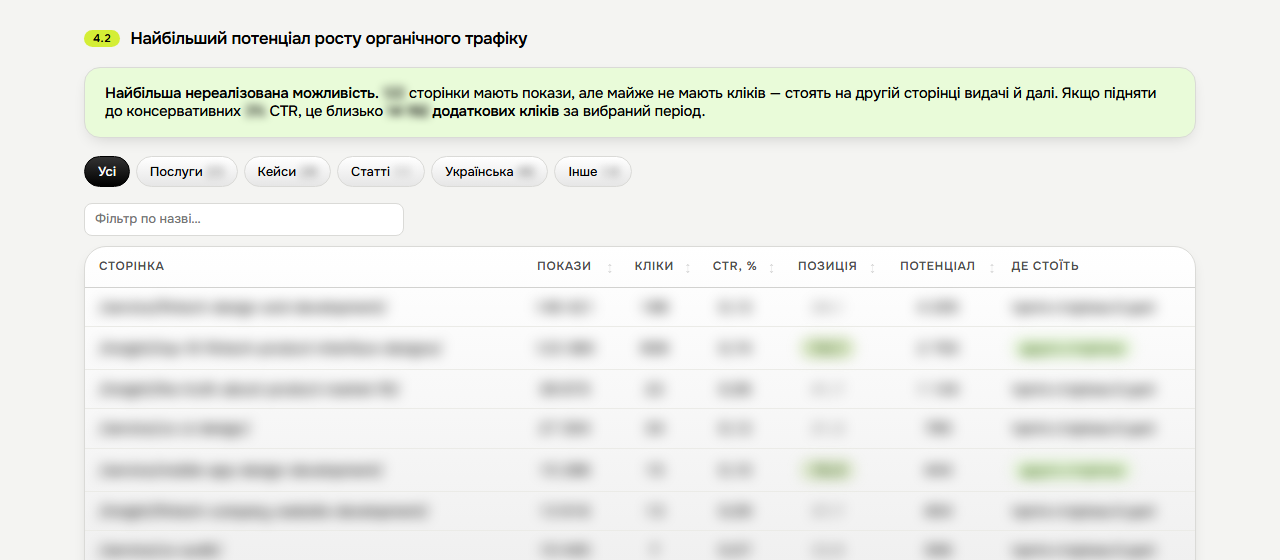
- Какие страницы имеют показы в поиске, но не получают кликов — и что из них стоит на второй странице выдачи, то есть ближе всего к результату.
- Появился ли канал, которого в прошлом году не было: AI-ассистентов мы увидели в данных именно так — отдельным источником, а не догадкой.
- Совпадает ли самый большой канал по объёму с лучшим по заявкам. По нашему опыту чаще не совпадает — и именно это меняет решение о бюджете.
- Из каких источников приходят сделки в CRM — с датой, формой и стадией каждой.
- Целы ли сами данные: ежедневные проверки следят, чтобы стык был на месте, цифры свежие, а заявки сходились со сделками — и предупреждают команду первыми.
Самое важное — изменился разговор. Раньше вопрос «откуда этот клиент» требовал догадок. Теперь ответ лежит в карточке сделки, и его не вписывал человек.
Такую связку мы собираем под ключ — на странице услуги есть стоимость, этапы и сроки: сквозная аналитика.
Первое впечатление — выглядит очень круто. Начал погружаться, интересные инсайты!
— владелец агентства, на следующий день после открытия дашборда